
ประเภทงาน
การจดจำภาพ hCaptcha
หน้านี้แปลด้วยเครื่องจากเวอร์ชันภาษาจีน อาจมีข้อผิดพลาด โปรดยึดเวอร์ชันภาษาจีนเป็นหลัก
1
2
3
4
5GIF · 12 FPS
HCaptchaClassification จดจำโจทย์ภาพที่ hCaptcha แสดงขึ้นมา: ส่งคำถามและรูปภาพเข้ามา แล้วระบบจะคืนค่าว่าควรเลือกรูปใด ควรคลิกตำแหน่งใด หรือควรลากจากจุดไหนไปจุดไหน จากนั้นให้โปรแกรมของคุณดำเนินการในเบราว์เซอร์ ไม่คืนค่า token ส่งผลลัพธ์แบบซิงโครนัส ราคาครั้งละ 8 พอยต์ (≈ $1.20 / 1k) และไม่หักพอยต์เมื่อไม่พบเป้าหมาย (ผลลัพธ์ว่าง)
https://api.yescaptcha.com/createTaskendpoint ทั่วโลกhttps://cn.yescaptcha.com/createTaskendpoint จีนประเภทงานและราคา
หัวข้อที่มีชื่อว่า “ประเภทงานและราคา”| ประเภทงาน | ราคา | รูปแบบการคืนผลลัพธ์ | หมายเหตุ |
|---|---|---|---|
HCaptchaClassification | $1.20 / 1k; 8 พอยต์/งาน · ¥8 / 1k | แบบซิงโครนัส | ไม่หักพอยต์เมื่อไม่พบเป้าหมาย |
ราคาเป็นดอลลาร์สหรัฐเป็นเพียงค่าประมาณที่ US$1 ≈ ¥6.67 งานจะถูกหักเป็นพอยต์
พารามิเตอร์ของคำขอ
หัวข้อที่มีชื่อว่า “พารามิเตอร์ของคำขอ”| ฟิลด์ | ประเภท | จำเป็น | คำอธิบาย |
|---|---|---|---|
type | string | ใช่ | ประเภทงาน ดูค่าที่ใช้ได้ในหัวข้อ "ประเภทงานและราคา" ของหน้านี้ |
queries | array | ใช่ | รายการภาพโจทย์ที่เข้ารหัส Base64 เรียงตามลำดับบนหน้าเว็บ (ตาราง 3×3 จะมี 9 ภาพย่อย) |
question | string | ไม่ | คำถามฉบับเต็มตามที่แสดงบนหน้าเว็บ (แนะนำภาษาจีนตัวย่อหรือภาษาอังกฤษ) เช่น Please click each image containing a bicycle ต้องส่ง question หรือ anchors อย่างน้อยหนึ่งรายการ และแนะนำให้ส่งทั้งสองรายการ |
anchors | array | ไม่ | รายการภาพตัวอย่างที่แสดงอยู่ข้างคำถาม เข้ารหัส Base64 โจทย์ที่มีภาพตัวอย่างต้องส่งด้วย |
questionให้ส่งประโยคคำถามทั้งประโยคตามที่แสดงบนหน้าเว็บ ไม่ต้องแปลเป็นภาษาอื่น และแนะนำให้ตั้งค่า hCaptcha เป็นภาษาจีนตัวย่อหรือภาษาอังกฤษ โจทย์รูปแบบใหม่มักได้รับการรองรับอย่างรวดเร็ว ส่วนหมวดหมู่ใหม่ทั้งหมดจะรองรับภายใน 3 วันทำการ
การเลือกในตาราง
หัวข้อที่มีชื่อว่า “การเลือกในตาราง”โจทย์ในรูปแบบ “Please click each image containing …” โดยมีรูปเล็ก 9 รูปด้านล่าง ใส่ Base64 ของรูปทั้ง 9 ใน queries ตามลำดับ:
{ "clientKey": "YOUR_CLIENT_KEY", "task": { "type": "HCaptchaClassification", "question": "Please click each image containing a bicycle", "queries": ["BASE64_IMAGE_1", "BASE64_IMAGE_2"] }}ผลลัพธ์:
{ "errorId": 0, "status": "ready", "solution": { "objects": [true, false, false, true, true, false, true, true, false], "top_k": [0, 3, 4, 6, 7], "confidences": [1.0, 0.0, 0.0, 1.0, 1.0, 0.0, 1.0, 1.0, 0.0] }}objects และ top_k มีความหมายเดียวกัน โดยอย่างแรกบอกว่าแต่ละรูปเป็นเป้าหมายหรือไม่ ส่วนอย่างหลังเป็นลำดับของรูปที่เป็นเป้าหมาย (เริ่มจาก 0) ให้คลิกรูปเหล่านั้น
คลิกตำแหน่งที่กำหนด
หัวข้อที่มีชื่อว่า “คลิกตำแหน่งที่กำหนด”โจทย์ในรูปแบบ “Please click on …” โดยมีรูปใหญ่หนึ่งรูปด้านล่าง และต้องคลิกตำแหน่งหนึ่งหรือหลายตำแหน่งบนรูปนั้น
- ใช้
questionตามที่แสดงบนหน้าเว็บ หากมีภาพตัวอย่างขนาดเล็ก ให้ใส่ในanchors - ใส่รูปหนึ่งรูปใน
queriesควรใช้รูปต้นฉบับที่ส่งออกจาก canvas โดยตรง (แนะนำให้แปลงเป็น JPG) หากทำได้เพียงแคปหน้าจอ ให้แคปเฉพาะพื้นที่รูปใหญ่ในกรอบสีแดงด้านล่าง ห้ามเกินหรือขาด boxในผลลัพธ์คือพิกัดที่ต้องคลิก เรียงเป็น x1, y1, x2, y2, … โดยใช้มุมซ้ายบนของรูปที่อัปโหลดเป็นจุดเริ่มต้น- หากขนาดของรูปที่อัปโหลดต่างจากขนาดที่แสดงบนหน้าเว็บ ต้องแปลงค่า: x บนหน้าเว็บ = x ที่ได้รับ × ความกว้างที่แสดง ÷ ความกว้างของรูปที่อัปโหลด (y ก็เช่นเดียวกัน) ตัวอย่างเช่น ได้ x = 769 โดย canvas แสดงกว้าง 350 และรูปที่อัปโหลดกว้าง 1000 บนหน้าเว็บต้องคลิกที่ 769 × 350 ÷ 1000 ≈ 269
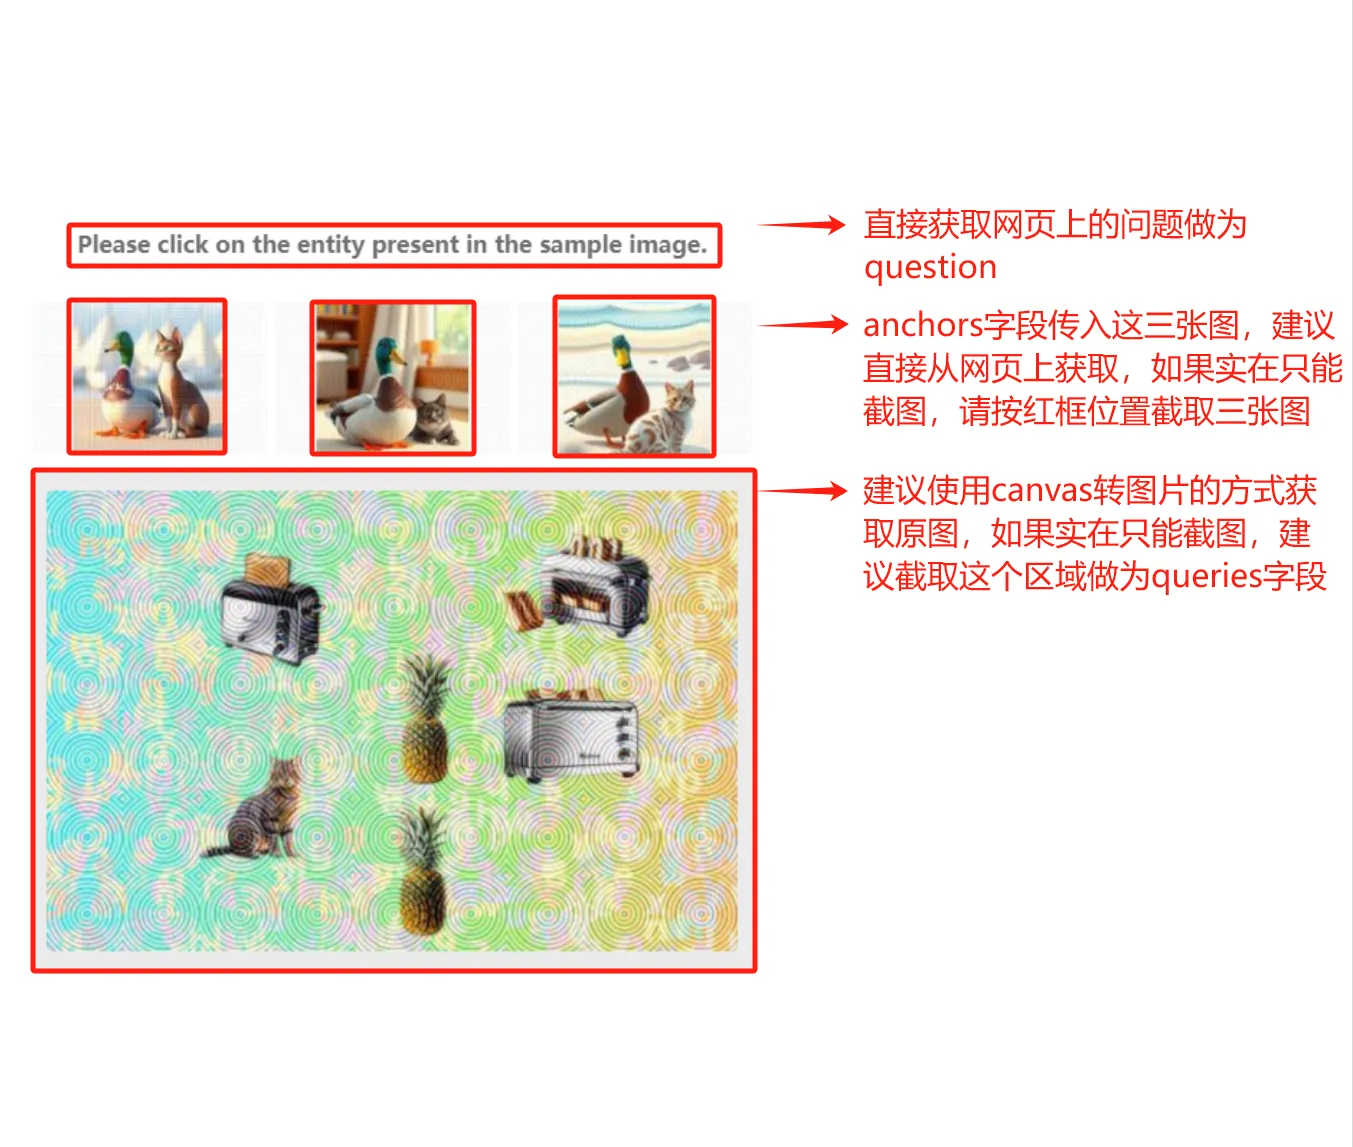
{ "clientKey": "YOUR_CLIENT_KEY", "task": { "type": "HCaptchaClassification", "question": "Please click on the entity present in the sample image.", "anchors": ["BASE64_ANCHOR_1", "BASE64_ANCHOR_2", "BASE64_ANCHOR_3"], "queries": ["BASE64_OF_THE_BIG_IMAGE"] }}ผลลัพธ์:
{ "errorId": 0, "status": "ready", "solution": { "box": ["221", "213"] }}หากต้องคลิกเป้าหมายหลายจุด box จะเป็นพิกัดหลายคู่เรียงต่อกัน: ["221", "213", "340", "118", ...]
ลากไปยังตำแหน่งที่กำหนด
หัวข้อที่มีชื่อว่า “ลากไปยังตำแหน่งที่กำหนด”โจทย์ในรูปแบบ “Drag … to …” ต้องลากชิ้นส่วนเล็กทางด้านขวาไปยังตำแหน่งที่ตรงกันในรูป
- ใช้
questionตามที่แสดงบนหน้าเว็บ - แคปรูปหนึ่งรูปใส่ใน
queriesโดยในรูปต้องมีทั้งชิ้นส่วนที่ต้องลากและตำแหน่งปลายทาง และแต่ละด้านของรูปต้องไม่น้อยกว่า 260 พิกเซล - แต่ละรายการใน
boxของผลลัพธ์คือการลากหนึ่งครั้ง โดยstartคือตำแหน่งของชิ้นส่วน และendคือตำแหน่งที่ต้องลากไปวาง หากมีหลายชิ้นส่วนให้ลากทีละชิ้น
{ "errorId": 0, "status": "ready", "solution": { "type": "drag", "box": [ { "start": [644, 218], "end": [239, 315] } ] }}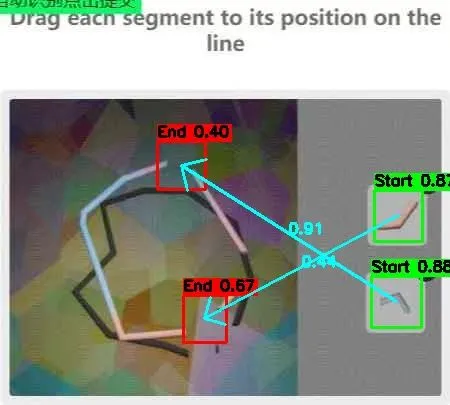
หากสิ่งที่คุณได้รับเป็นข้อมูลระดับโปรโตคอล (รูปของชิ้นส่วน พิกัดของชิ้นส่วน และรูปพื้นหลังขนาดใหญ่) ไม่ใช่ภาพที่แคปหน้าจอ ให้นำชิ้นส่วนไปวางบนรูปพื้นหลังตามพิกัดก่อน เพื่อให้ได้ภาพที่หน้าตาเหมือนภาพแคปหน้าจอ แล้วจึงส่งเข้ามา
โจทย์แบบแอนิเมชัน
หัวข้อที่มีชื่อว่า “โจทย์แบบแอนิเมชัน”เมื่อรูปของโจทย์เป็นแอนิเมชัน ให้ใส่ Base64 ของแอนิเมชัน (GIF หรือรูปแบบอื่น) ใน queries แนะนำให้แอนิเมชันยาวอย่างน้อย 3 วินาที ควรเป็น 5 ถึง 6 วินาที และมีเฟรมเรตประมาณ 12 FPS
การรายงานและการคืนพอยต์
หัวข้อที่มีชื่อว่า “การรายงานและการคืนพอยต์”หากคลิกแล้วการตรวจสอบไม่ผ่าน สามารถรายงานด้วย report ภายใน 1 ชั่วโมง และจะคืนพอยต์หลังรายงานเมื่อครบประมาณ 24 ชั่วโมง ดูกฎได้ที่ การเรียกเก็บเงินและการคืนพอยต์